
RPO y RTO no son solo términos de auditoría: son dos decisiones de negocio que acaban marcando cuánto cuesta tu backup, qué arquitectura necesitas y qué puedes exigir a tu proveedor. El RPO (Recovery Point Objective) fija cuántos datos puede perder la empresa ante un incidente, medido en tiempo. El RTO (Recovery Time Objective) fija cuánto tiempo puede estar parado un servicio hasta volver a funcionar.
Si solo necesitas la definición, la tienes resumida en nuestro glosario de RPO y RTO. Esta guía va un paso más allá: cómo calcular unos objetivos realistas para cada sistema, qué tecnología encaja con cada nivel, cómo se demuestra que se cumplen y qué debe recoger el contrato. Es el método que aplicamos en Impulso Tecnológico al diseñar backup, recuperación y continuidad para empresas.
RPO y RTO explicados desde la operación
El RPO responde a una pregunta sencilla: si ocurre un incidente, ¿desde qué punto necesitamos recuperar los datos? Si la última copia válida es de las 22:00 y el servidor falla a las 17:00 del día siguiente, se pierden diecinueve horas de trabajo. Para una carpeta de documentación interna puede ser asumible; para facturación, pedidos o el ERP, casi nunca lo es.
El RTO responde a otra: ¿en cuánto tiempo debe volver a funcionar el servicio para que el negocio no se bloquee? Incluye todo el camino, no solo la restauración de datos: detectar el problema, decidir qué hacer, preparar el hardware o el entorno cloud, restaurar, comprobar que usuarios, permisos e integraciones funcionan y avisar a la plantilla de que puede volver a trabajar.
Los dos objetivos son independientes. Un sistema puede tolerar perder un día de datos pero no puede estar parado más de dos horas (por ejemplo, una centralita o una web de pedidos que se puede reconstruir), y al revés: un archivo contable puede esperar a mañana, pero no puede perder ni un apunte. Por eso conviene fijarlos por separado.
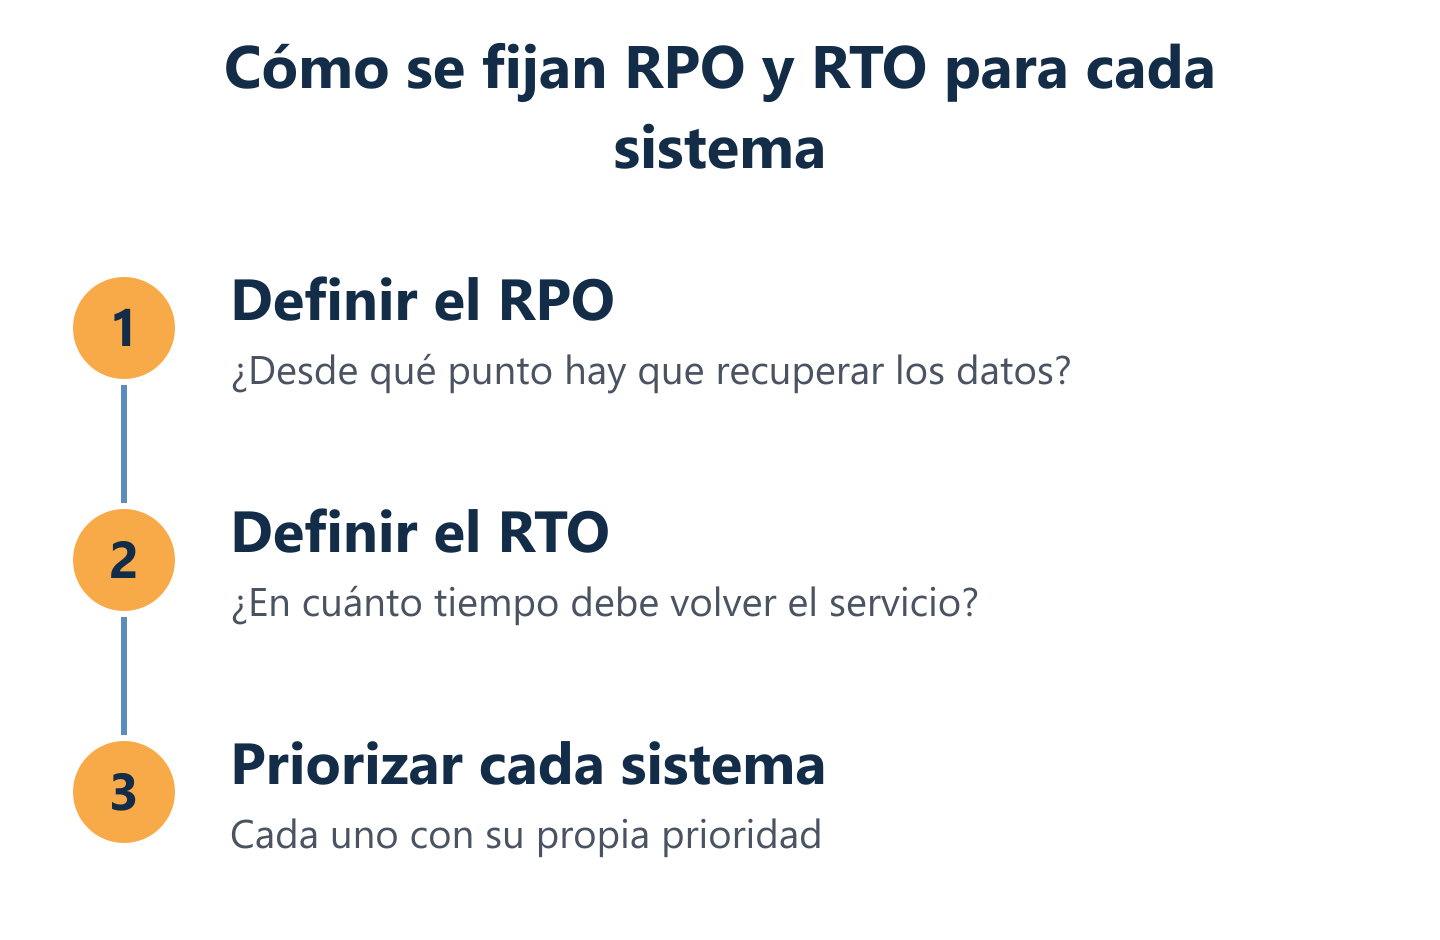
Cómo fijar el RPO y el RTO de cada sistema
El error habitual es definir ambos valores de forma genérica («queremos recuperar todo en cuatro horas»). Un objetivo global suele acabar en una de dos situaciones: o se paga una infraestructura sobredimensionada para sistemas que no lo necesitan, o se asume un objetivo que en realidad nadie ha comprobado. El método que funciona tiene tres pasos.
Paso 1: inventario de sistemas y dependencias
Se empieza por listar qué usa la empresa para trabajar: ERP, facturación, CRM, correo y Microsoft 365, servidores de ficheros, NAS, aplicaciones sectoriales, telefonía, web, VPN y equipos de usuario. Para cada sistema se anota dónde viven los datos, quién lo usa, qué proveedor interviene y de qué otros sistemas depende. Las dependencias importan: restaurar el ERP no sirve de nada si antes no funcionan el directorio de usuarios, la red o la licencia del fabricante.
Paso 2: coste de la parada y de la pérdida de datos
Con dirección y con los responsables de cada área se responden dos preguntas por sistema: qué pasa si está parado una hora, cuatro horas, un día o una semana, y qué pasa si se pierden los datos de la última hora o del último día. La respuesta no tiene que ser una cifra exacta; basta con separar lo que bloquea ventas, producción, cobros o atención al cliente de lo que solo causa molestias. También cuentan las obligaciones con clientes, seguros y auditorías, que a veces fijan mínimos por contrato.
Paso 3: niveles de criticidad
Con esa información se agrupan los sistemas en pocos niveles y se asigna a cada uno un objetivo. Un esquema orientativo de partida podría ser este; los valores reales salen del análisis de cada empresa:
| Nivel | Ejemplos habituales | RPO orientativo | RTO orientativo |
|---|---|---|---|
| Crítico | ERP, facturación, pedidos, sistemas de producción | Minutos o pocas horas | Pocas horas |
| Importante | Correo, CRM, ficheros de trabajo diario | Unas horas | Mismo día laborable |
| Tolerable | Archivo histórico, documentación interna, entornos de pruebas | 24 horas | Uno o varios días |
Tener tres o cuatro niveles bien justificados es más útil que un valor distinto para cada aplicación: simplifica la arquitectura, el contrato y las pruebas.
De los objetivos a la arquitectura de backup y recuperación
Una vez fijados los objetivos, la tecnología se elige para cumplirlos con el menor coste razonable. Cada salto en exigencia suele implicar un cambio de técnica, no solo «más copias»:
- RPO de 24 horas y RTO de días: copia diaria con retención suficiente y una copia fuera de la oficina. Es el mínimo para sistemas tolerables.
- RPO de horas: copias incrementales varias veces al día o instantáneas (snapshots) con versiones, para poder volver a un punto anterior a un borrado o a un cifrado.
- RTO de pocas horas: además de la copia, hace falta un sitio donde arrancar: virtualización, recuperación directa desde el backup o un entorno de recuperación en cloud preparado de antemano.
- RPO y RTO de minutos: replicación continua o alta disponibilidad entre dos ubicaciones. Es la opción más cara y solo se justifica en los sistemas donde una parada corta ya tiene un coste alto.
En cualquier nivel, la regla 3-2-1 sigue siendo una buena base: varias copias, en soportes distintos y al menos una fuera del entorno principal. Frente al ransomware conviene añadir una copia inmutable o desconectada, con credenciales separadas de las del dominio.
Backup cloud, copias inmutables y Microsoft 365
Las copias de seguridad en la nube ayudan a cumplir el requisito de copia externa, pero el RTO depende del ancho de banda: descargar varios terabytes puede llevar mucho más tiempo del que el negocio tolera. Por eso es frecuente combinar una copia local para restauraciones rápidas con una copia cloud para desastres mayores.
Microsoft 365 merece atención propia. La plataforma ofrece alta disponibilidad, pero eso no siempre cubre borrados de usuarios, errores de sincronización, retenciones concretas o la salida de un empleado. Si el correo, SharePoint o Teams son críticos, deben tener su propio RPO, RTO y copia, y conviene revisarlo junto al resto del entorno cloud y Microsoft 365.
Errores habituales al definir RPO y RTO
- Confundir la frecuencia de copia con el RPO real. Si la copia de las 22:00 falla y nadie revisa el aviso, el punto de recuperación real es el de la noche anterior.
- Medir el RTO solo como tiempo de restauración. El reloj empieza cuando se detecta el problema y acaba cuando los usuarios trabajan con normalidad, no cuando termina la barra de progreso.
- Olvidar las dependencias. Directorio de usuarios, DNS, licencias, certificados y conexiones con otros sistemas deben estar en el orden de recuperación.
- No prever el hardware. Si el servidor físico se ha perdido, el RTO incluye conseguir o preparar dónde arrancar. Sin un plan para eso, el objetivo es teórico.
- No revisar los objetivos tras los cambios. Una aplicación nueva, una migración a cloud o una sede adicional pueden dejar fuera sistemas que antes estaban cubiertos.
Preguntas que debe responder el plan
Un buen plan de recuperación responde a preguntas concretas: qué ocurre si se cifra un servidor, si se borra una carpeta, si cae la conexión principal, si Microsoft 365 pierde un buzón crítico, si se rompe un NAS o si una sede queda sin acceso. Cada escenario necesita responsables, prioridades y pasos de recuperación escritos, y alguien con autoridad para decidir cuándo se activa.
También debe aclarar qué datos se restauran primero y quién valida que la recuperación es correcta. Sin esa validación, la empresa puede creer que ya está operativa mientras usuarios, permisos, integraciones o históricos siguen fallando.
Cuando estos objetivos tienen que cubrir a toda la empresa (personas, sedes, proveedores y comunicación de crisis, no solo los sistemas), el paso siguiente es un plan de continuidad de negocio.
Pruebas y evidencias: cómo demostrar que el RTO se cumple
La diferencia entre tener copias y tener continuidad está en las pruebas. Recomendamos tres tipos con cadencias distintas:
- Comprobación diaria de la copia: que todos los trabajos han terminado bien y que cualquier fallo genera un aviso que alguien atiende.
- Restauraciones parciales periódicas: recuperar ficheros, buzones o una base de datos concreta para confirmar que los datos se pueden leer y están completos.
- Prueba de recuperación completa de los sistemas críticos: al menos una vez al año y tras cambios relevantes, cronometrando cada fase y comparando el resultado con el RTO y el RPO comprometidos.
Cada prueba debe dejar un registro: fecha, sistema, tiempo obtenido, problemas encontrados y acciones de mejora. Cuando existen requisitos de clientes, seguros o auditorías, estas evidencias son tan importantes como la propia tecnología, porque demuestran que la empresa mantiene un proceso vivo de protección y recuperación.

Qué exigir a un proveedor de backup y continuidad
Si externalizas el backup o la recuperación, los objetivos tienen que pasar al contrato. Antes de firmar conviene comprobar que el proveedor:
- Recoge el RPO y el RTO por sistema o por nivel de criticidad, no un valor genérico para todo.
- Detalla qué hace y en qué plazo cuando una copia falla, y quién recibe el aviso.
- Incluye pruebas de restauración con una cadencia definida y te entrega el informe con los tiempos medidos.
- Explica dónde se guardan las copias, con qué retención, cifrado y protección frente a borrado o cifrado malicioso.
- Aclara qué queda fuera: aplicaciones no incluidas, hardware de sustitución, horarios y responsabilidades de otros proveedores.
- Revisa los objetivos cuando cambia el entorno, y no solo al principio del servicio.
En Impulso Tecnológico gestionamos backup y recuperación dentro de nuestros servicios gestionados, con monitorización de copias, pruebas documentadas y soporte cuando hay que restaurar. Llevamos 26 años trabajando con más de 470 organizaciones; en Madrid operamos con equipo propio y en el resto de España y Portugal con técnicos locales y partners.
Siguiente paso
Si quieres definir RPO y RTO de forma práctica, podemos empezar con una llamada gratuita de 30 minutos para entender tus sistemas críticos y cómo haces hoy las copias. Si tiene sentido seguir, realizamos un estudio de alcance y te entregamos una propuesta cerrada con los objetivos por sistema, la arquitectura de backup y recuperación y el plan de pruebas.